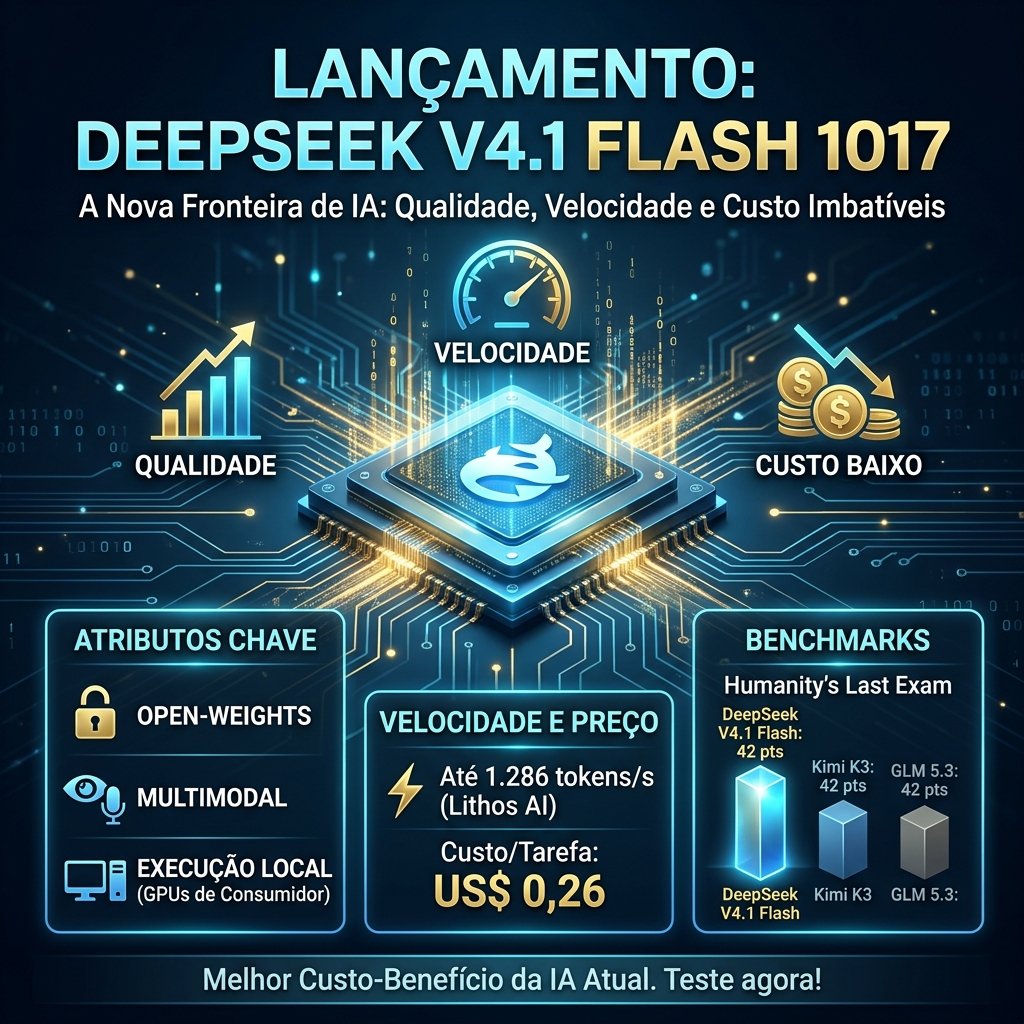

Existe um consenso silencioso no mercado de IA: modelos de ponta custam caro, modelos baratos são limitados, e modelos abertos ficam sempre um degrau abaixo. O DeepSeek V4.1 Flash é a evidência mais recente de que esse consenso está sendo desmontado. Depois de acompanhar uma bateria extensa de testes práticos — de um relógio mecânico 3D hiper-realista a um clone funcional de Excel —, fica difícil não concluir que estamos diante de um divisor de águas.
Neste post, vou analisar o que os testes revelaram, o que os benchmarks dizem (e o que eles escondem), onde o modelo brilha, onde tropeça e, principalmente, como você pode usar essas informações para tomar decisões melhores sobre qual modelo colocar no seu fluxo de trabalho.
1. O que é o DeepSeek V4.1 Flash, afinal?
O DeepSeek V4.1 Flash é apresentado como o melhor modelo de código aberto/pesos abertos do planeta e, possivelmente, o melhor modelo geral do momento quando se considera a combinação de fatores que realmente importam na prática.
1.1 Características centrais
- Multimodal: aceita imagens como entrada, o que abre espaço para análise visual, OCR, contagem de objetos e tarefas de compreensão espacial.
- Pesos abertos: pode ser baixado e executado localmente, inclusive em versões quantizadas para GPUs de consumidor de alto desempenho.
- Transparência de raciocínio: por ser de pesos abertos, permite visualizar a cadeia de pensamento e as chamadas de ferramentas — algo valioso para depuração e auditoria.
- Velocidade extrema: pode ultrapassar 1.000 tokens por segundo em provedores de inferência otimizados.
- Custo baixíssimo: em métricas de custo por tarefa de inteligência, aparece na casa dos US$ 0,26, contra centenas de dólares de concorrentes de ponta.
1.2 O posicionamento estratégico
A grande sacada do V4.1 Flash não é ser o melhor em tudo. É ser suficientemente próximo do topo em qualidade, enquanto oferece velocidade e custo em ordens de grandeza diferentes. Essa combinação — e não a excelência absoluta em um único eixo — é o que o coloca no canto superior esquerdo da fronteira de Pareto, a posição mais desejável em qualquer análise de custo-benefício.
Opinião do blogueiro: estamos entrando na era em que “qualidade absoluta” é uma métrica cada vez menos relevante para a maioria dos casos de uso. Se um modelo entrega 90% a 95% do resultado de um concorrente que custa 100 a 1.000 vezes mais, a pergunta deixa de ser “qual é o melhor?” e passa a ser “por que você ainda está pagando pelo outro?”.
2. Por que “pesos abertos” muda o jogo (e não é só ideologia)
Muita gente trata “open weights” como uma bandeira filosófica. Na prática, é uma vantagem operacional concreta. Veja por quê:
2.1 Soberania de dados
Rodar localmente significa que nenhum token do seu documento sensível sai da sua infraestrutura. Para escritórios jurídicos, hospitais, órgãos públicos e empresas com compliance rígido, isso não é um detalhe — é um pré-requisito.
2.2 Custo marginal próximo de zero
Se você já tem o hardware, o custo por inferência local é essencialmente energia elétrica. Um leitor de PDF completo, por exemplo, saiu praticamente de graça rodando localmente. Em um provedor de inferência, custaria menos de alguns dólares para gerar um aplicativo que você usa pela vida toda.
2.3 Auditabilidade
Poder ver a cadeia de pensamento e as chamadas de ferramentas é ouro para quem precisa depurar comportamentos estranhos, criar guardrails ou simplesmente entender por que o modelo tomou determinada decisão.
2.4 Independência de fornecedor
Você não fica refém de mudanças de preço, descontinuação de modelos ou alterações unilaterais de política de uso. O modelo é seu.
3. Os nove testes práticos: o que o DeepSeek V4.1 Flash realmente entregou
Benchmarks são uma coisa; aplicações reais são outra. A bateria de testes a seguir cobre geração 3D, jogos, visão computacional, uso de navegador, velocidade de escrita e desenvolvimento de software completo. Vamos por partes.
3.1 Mechanica: o relógio mecânico 3D
O pedido foi um diagrama 3D hiper-realista de um relógio mecânico, com informações ao passar o mouse sobre cada peça.
O que funcionou:
- Peças pequenas se encaixam corretamente.
- Iluminação e sombras 3D convincentes.
- Ponteiros de segundos, minutos e horas funcionando.
- Tooltips com nome e função de cada componente.
- Recursos de destacar, centralizar, dar zoom, girar, ver a parte de trás e usar a visão “explodir”, que separa as camadas.
O detalhe que mais impressiona é a precisão conceitual. A descrição da mola cabelo/espiral — “uma espiral plana de aço temperado, não mais espessa que um fio de cabelo, que armazena energia cinética do balanço e define o ritmo do relógio” — mostra que o modelo não está apenas gerando geometria bonita; ele entende a função mecânica de cada componente.
A limitação: faltou o peso/rotor traseiro de corda automática. Um deslize pontual, mas que não compromete o conjunto.
Veredito: excelente em detalhe, noção espacial, geração 3D, iluminação e sombras.
3.2 Bean Blitz: o clone de Fall Guys
O prompt foi minimalista: “Construir um clone de Fall Guys”. O resultado foi um jogo em HTML com bom visual 3D.
Pontos positivos:
- Martelos derrubam o personagem.
- Mergulho com barra de espaço funciona.
- Visual geral agradável.
Problemas:
- Clipping entre objetos.
- Alguns objetos que deveriam girar não giram.
- Não é possível cair no ácido.
Veredito: muito impressionante, mas não tão bom quanto o Opus 5.5. Ainda assim, é bem próximo, custa uma fração do preço e é muito mais rápido. Para prototipagem rápida, é uma escolha excelente.
3.3 iPhone Duo 3D
Aqui o modelo precisou buscar especificações e design na web e recriar o dispositivo em 3D.
O que funcionou:
- Logo da Apple perfeito.
- Reflexo de luz na tela.
- Acabamento fosco na tela interna.
- Botões nos lugares certos.
- Dobradiça correta.
Comparado ao novo modelo Kimmy, o DeepSeek foi muito melhor.
Problemas:
- A animação de dobrar faz o objeto sair da tela.
- O protetor de tela desaparece por um instante ao dobrar.
Veredito: resultado incrível, com ajustes finos necessários na animação.
3.4 Contagem de pastéis: o teste multimodal mais revelador
Este é, talvez, o teste mais interessante de todos, porque mede algo que muitos modelos erram feio: compreensão espacial e contagem de objetos em cenas densas.
O modelo levou 4 minutos e 25 segundos e contou 137 pastéis visíveis. Nomeou os itens: 24 macarons laranja na pirâmide, 8 croissants de manteiga, 9 croissants com recheio de creme, entre outros. O observador humano contou 25 macarons visíveis — uma diferença de apenas 1 unidade, discutível.
O mais impressionante é o que o modelo fez sem ser solicitado:
- Reconheceu que macarons, croissants e brownies estavam empilhados, com alguns parcial ou totalmente escondidos.
- Estimou uma faixa defensável de 130 a 145 itens no balcão.
- Ao pedir uma estimativa total incluindo escondidos, adicionou 21 macarons ocultos e cerca de 5 croissants atrás dos visíveis.
E aí vem o raciocínio espacial de verdade:
- Descreveu a pilha de macarons como um monte cônico com 5 a 6 unidades de largura na base e 5 a 6 camadas de altura.
- Argumentou que uma face triangular frontal de 24 implica base de aproximadamente 19 a 25, então 45 no total seria mais provável que 24.
- Para croissants, estimou pilhas de 2 a 3 camadas e adicionou cerca de 60% à contagem visível.
Veredito: compreensão visual estelar. A contagem inicial levou 4,5 minutos; a complementar, mais 23 segundos com raciocínio máximo. Esse tipo de desempenho sugere aplicações sérias em inspeção de qualidade industrial, agricultura de precisão, varejo e logística.
3.5 Velocidade de escrita
Com o esforço de raciocínio desligado, foi pedido um conto de 1.000 palavras diretamente na janela de chat, sem ferramentas.
- Velocidade observada na interface: cerca de 125 a 150 tokens por segundo.
- Pode chegar a 1.286 tokens por segundo pela Lithos AI e a 845 tokens por segundo pela Base10.
Para comparação: a leitura humana confortável gira em torno de 200 a 300 palavras por minuto. O modelo escreve mais rápido do que você consegue ler.
3.6 Sam Altman e os cinco clipes mais “clipáveis”
O pedido foi revisar uma entrevista de Sam Altman e extrair os 5 momentos mais “clipáveis”, com timestamps exatos e justificativas. O modelo trabalhou por 6 minutos e 24 segundos usando o navegador.
O primeiro clipe escolhido foi a fala de que ele não olhou uma linha de código em provavelmente um ano. O timestamp foi verificado como correto.
A justificativa do modelo foi cirúrgica:
- É noticioso o CEO da OpenAI admitir que não lê código há um ano.
- A imagem da “Guerra Revolucionária” é vívida, engraçada e funciona fora da bolha da IA.
- É autodepreciativo, não exige contexto e serve perfeitamente para Shorts/TikTok.
- Gancho: “Sam Altman não lê uma linha de código há um ano”.
Outros clipes escolhidos: “programadores nunca estiveram tão ocupados” e “o debate sobre consciência da IA é uma porta dos fundos para tirar poder das pessoas”. Neste último, o trecho destacado foi o desconforto do entrevistado quando o debate sobre consciência é usado para sugerir que talvez as pessoas não devam sempre controlar o futuro — porque o futuro precisa ser sobre pessoas.
Veredito: a curadoria foi tão boa que o observador afirmou que escolheria os mesmos clipes pessoalmente. É um caso de uso muito promissor para criadores de conteúdo e social media.
3.7 GridLine: o clone de Excel
Carregado localmente em uma estação DJX, o modelo trabalhou por 50 minutos e criou o GridLine, um clone de Excel para navegador, offline-first.
Funcionalidades verificadas:
- Soma
23 + 44 = 67. - Referência
B7 + C7funciona. - Negrito.
- Arrastar para baixo continua a fórmula.
- Inserção de gráficos simples e bonitos.
- Visualização de outro gráfico.
- Arrastar e soltar.
Não tem todas as funções do Excel — longe disso —, mas para um clone gerado a partir de um prompt, é muito bom. E o detalhe importante: rodou localmente.
3.8 Cubo de Rubik 3D
Prompt simples: construir uma simulação 3D de um cubo de Rubik, embaralhar e resolver. O objetivo era testar se o modelo entende o objeto esperado sem instruções detalhadas.
Resultado:
- Todas as faces corretas — branco, azul, laranja, amarelo, verde e vermelho.
- Após embaralhar, as cores continuam nos lados apropriados.
- Os movimentos aparecem na tela.
- A resolução funciona.
- Rotações e física do cubo precisas.
Veredito: impressionante para um modelo de pesos abertos que pode ser baixado e usado livremente.
3.9 Folio: o leitor e anotador de PDF
A motivação foi criar um leitor de PDF para Windows porque o Adobe Acrobat é considerado inchado, cheio de spam e com 90% de funções desnecessárias.
O processo foi interessante: primeiro, pediu-se ao Opus 5.5 um prompt detalhado; depois, esse prompt foi colado no DeepSeek com configurações altas de raciocínio.
Stack: Electron, React, TypeScript e PDF.js.
Design: tema claro em branco quente e tema escuro quase preto, bordas sutis e controles compactos.
Funcionalidades entregues:
- Arrastar e soltar.
- Destacar texto.
- Navegação por páginas e índice.
- Ocultar janela.
- Zoom.
- Desenhar com cores diferentes, mover desenhos e alterar cor.
- Adicionar nota de texto.
- Assinaturas desenhadas, enviadas ou capturadas por câmera e depois invertidas.
- Modo escuro para qualquer PDF.
- Salvar, exportar, ajustar à página, girar no sentido horário e imprimir.
Veredito: um leitor/editor bonito, simples e funcional. Rodando localmente, foi praticamente gratuito; pagando um provedor de inferência, provavelmente custaria menos de alguns dólares para criar um leitor de PDF para a vida toda.
Insight prático: esse é o padrão que mais me empolga. Não é sobre substituir o Excel ou o Acrobat. É sobre criar ferramentas sob medida para fluxos de trabalho específicos, com custo marginal próximo de zero. A “long tail” de software que nunca foi construída porque não valia a pena comercialmente agora se torna viável.
4. Benchmarks: o que os números dizem (e o que escondem)
4.1 Fronteira de Pareto
No gráfico de Pareto Frontier de qualidade combinada com custo, o DeepSeek aparece no canto superior esquerdo — a posição desejada: mais alto é melhor e mais à esquerda é mais barato. Ele supera modelos como Opus 5, Fable 5, GPT 6.1 Soul, Astra 6 Soul, Gemini 3.8 Flash e GLM 5.3 Max.
4.2 Benchmarks específicos
| Benchmark | Pontuação |
|---|---|
| Humanity’s Last Exam | 42 (empatado com Kimmy K3 e GLM 5.3) |
| Terminal Bench | 42 |
| Automation Bench / Agents Last Exam | Bom desempenho |
4.3 Custo por tarefa de inteligência
Esta é a métrica que mais importa para quem paga a conta. Ela combina o custo do modelo e a quantidade de tokens usados por tarefa. Quanto menor o custo e maior a densidade de inteligência, melhor.
| Modelo | Custo por tarefa |
|---|---|
| Claude Fable 5.1 Max | US$ 763 |
| Kimi/Kimmy K3.1 Pro | US$ 211 |
| Qwen/Quen 3.8 Max | US$ 5 |
| Astra | US$ 3,26 |
| DeepSeek V4.1 Flash | US$ 0,26 |
A diferença é de três ordens de grandeza em relação ao topo da tabela. Mesmo contra o Astra, é mais de 12 vezes mais barato.
4.4 Preços de inferência
Lithos AI:
- US$ 0,60 por milhão de tokens de saída.
- US$ 0,15 por milhão de tokens de entrada.
- Grátis em caso de acerto de cache.
Base10:
- Cerca de 800 tokens por segundo.
- US$ 120 por milhão de tokens de saída.
- US$ 0,30 por milhão de tokens de entrada.
- US$ 0,01 por milhão de tokens de cache hit.
Perceba a diferença brutal entre provedores. Para cargas de trabalho intensivas em saída, o Lithos AI é ordens de magnitude mais barato que o Base10. Escolher o provedor certo é tão importante quanto escolher o modelo certo.
4.5 O alerta sobre benchmarks
O próprio teste deixa claro: benchmarks contam apenas parte da história. O Kimi/Kimmy K3.1 Pro, novo modelo da Moonshot, teve pontuação geral maior nos benchmarks, mas nos testes práticos o DeepSeek foi considerado pessoalmente muito melhor.
Recomendação: nunca decida com base apenas em leaderboards. Construa um conjunto de avaliações com seus próprios casos de uso, com seus próprios dados e com suas próprias métricas de sucesso. Benchmarks públicos são um ponto de partida, não um veredito.
5. CoreWeave Arena: testando carga antes de ir para produção
Um detalhe frequentemente ignorado por quem adota modelos de IA é a capacidade de infraestrutura. Não adianta o modelo ser barato se o seu provedor cai sob carga.
5.1 O que é o CoreWeave Arena
O CoreWeave Arena é apresentado como uma ferramenta para testar carga de IA antes de colocar em produção. No Forge, plataforma de desenvolvimento de IA da CoreWeave, é possível simular 1, 5 e 10 requisições, observando:
- Tempo de resposta.
- Throughput.
- Custo estimado.
5.2 O que os testes revelaram
Com 10 requisições, o tempo foi maior que com 5 — o que era esperado. A assistente Arya recomendou reduzir processamento desnecessário em cada resposta. É exatamente o tipo de insight que você quer obter antes de assinar um contrato de infraestrutura.
O Arena é um programa guiado para testar a infraestrutura do Forge com engenheiros da CoreWeave. A empresa se posiciona como “a nuvem essencial para IA”.
Dica prática: antes de lançar qualquer produto baseado em LLM, simule a carga real. Latência percebida pelo usuário e custo por requisição são os dois fatores que mais matam projetos de IA em produção — e ambos são previsíveis com testes adequados.
6. Onde o DeepSeek V4.1 Flash tropeça
Nenhuma análise honesta seria completa sem as limitações. Nos testes, apareceram:
6.1 Falhas pontuais de completude
- Rotor ausente no relógio mecânico, apesar de todo o resto estar correto.
6.2 Problemas de física e colisão
- Clipping entre objetos no clone de Fall Guys.
- Objetos que deveriam girar não giram.
- Impossibilidade de cair no ácido.
6.3 Animações com defeitos
- O iPhone sai da tela ao dobrar.
- O protetor de tela desaparece por um instante na dobra.
6.4 Tarefas mais complexas
O modelo é descrito como melhor custo-benefício sem sacrificar muita qualidade, exceto nas tarefas mais complexas. Ou seja, para o que é realmente difícil, ainda existe um gap em relação aos modelos de topo — como o Opus 5.5, que foi melhor no clone de Fall Guys.
Como interpretar isso: erros de física e colisão são sintomas clássicos de modelos que ainda não têm um “mundo interno” perfeitamente consistente. Para protótipos e MVPs, isso é irrelevante. Para produção de jogos comerciais, você vai precisar de revisão humana e iteração.
7. Comparações diretas: DeepSeek vs. concorrência
| Critério | DeepSeek V4.1 Flash | Opus 5.5 | Kimmy K3.1 Pro |
|---|---|---|---|
| Clone de Fall Guys | Muito bom | Melhor | Não testado |
| iPhone Duo 3D | Muito melhor | Não testado | Pior |
| Custo por tarefa | US$ 0,26 | Alto | US$ 211 |
| Execução local | Sim | Não | Não |
| Velocidade | Até 1.000+ t/s | Moderada | Moderada |
Leitura estratégica: o DeepSeek não vence em todos os eixos, mas vence nos eixos que mais importam para a maioria das pessoas: custo, velocidade, privacidade e liberdade de execução.
8. Recomendações práticas: quando usar (e quando não usar)
8.1 Use o DeepSeek V4.1 Flash quando:
- O custo é um fator crítico — startups, projetos pessoais, experimentação em larga escala.
- Você precisa de privacidade — dados sensíveis que não podem sair da sua infraestrutura.
- Você quer velocidade — prototipagem rápida, geração de conteúdo em massa, chat em tempo real.
- Você quer prototipar antes de investir — valide a ideia com um modelo barato antes de migrar para um caro.
- Você faz tarefas multimodais moderadas — contagem de objetos, análise de imagens, OCR.
- Você quer ferramentas internas sob medida — o caso do Folio é exemplar.
8.2 Considere outro modelo quando:
- A tarefa exige consistência física perfeita — jogos comerciais, simulações de engenharia.
- A complexidade é extrema — raciocínio de altíssimo nível, pesquisa científica de ponta.
- Você precisa de garantias de fornecedor — SLA, suporte enterprise, auditoria formal.
8.3 Checklist para avaliar por conta própria
- ☐ Defina 5 a 10 tarefas representativas do seu uso real.
- ☐ Crie uma rubrica de avaliação com critérios objetivos.
- ☐ Rode os mesmos prompts em 2 a 3 modelos.
- ☐ Meça custo, latência e qualidade lado a lado.
- ☐ Teste carga com ferramentas como o CoreWeave Arena.
- ☐ Compare provedores de inferência (Lithos AI vs. Base10 vs. local).
- ☐ Documente os resultados e revise trimestralmente.
9. Conclusão: o custo-benefício virou o novo benchmark
O DeepSeek V4.1 Flash impressionou pela combinação de qualidade, velocidade, custo baixíssimo e possibilidade de execução local. É, sem exagero, o melhor modelo de pesos abertos já testado nesta bateria — e, possivelmente, o melhor modelo geral do momento em custo-benefício.
Apesar de pequenas falhas pontuais — o rotor ausente no relógio, o clipping no clone de Fall Guys, a animação de dobra do iPhone —, os resultados foram classificados como altamente impressionantes. E o mais importante: os erros são do tipo que iteração e revisão humana resolvem rapidamente, enquanto as vantagens (custo, velocidade, privacidade) são estruturais.
O que fica para quem trabalha com IA
- Pare de escolher modelo por marca. Escolha por caso de uso, custo e requisitos de privacidade.
- Rode localmente sempre que possível. O custo marginal é próximo de zero e a soberania de dados é um ativo.
- Teste provedores antes de assinar. A diferença entre Lithos AI e Base10 é de ordens de grandeza.
- Valide com seus próprios dados. Benchmarks públicos são propaganda; seus testes são evidência.
- Aproveite a “long tail” de software. Ferramentas sob medida que antes não valiam a pena agora são viáveis.
A era em que “o melhor modelo” era uma resposta única está terminando. No lugar dela, surge uma pergunta muito mais interessante: qual é a combinação mais inteligente de modelo, provedor e infraestrutura para o meu problema específico? O DeepSeek V4.1 Flash acaba de se tornar uma das respostas mais fortes a essa pergunta.